Microsoft 365 – Wenn Hochverfügbarkeit zum Ausfallrisiko wird

Wie ein monatelang unentdeckter Softwarefehler, automatisierte Ausfallsicherheit und fehlende Fehlerisolierung eine globale Cloud-Infrastruktur zu Fall brachten.
Hochverfügbarkeit ist eines der zentralen Verkaufsargumente großer Cloud-Anbieter. Geografisch verteilte Rechenzentren, redundante Infrastruktur, automatisierte Wiederherstellung und nahezu unbegrenzte Skalierbarkeit sollen jene Ausfallsicherheit gewährleisten, die Unternehmen mit ihrer eigenen IT-Infrastruktur nur schwer erreichen können.
Doch was passiert, wenn genau diese Mechanismen einen Ausfall nicht verhindern, sondern beschleunigen?
Der weltweite Ausfall von Microsoft 365 am 12. November 2026 liefert hierfür ein bemerkenswertes Beispiel. Er zeigt, wie aus mehreren zunächst beherrschbaren Problemen innerhalb kürzester Zeit ein globaler Infrastruktur-Ausfall entstehen kann.
Und er zeigt, dass Redundanz und Resilienz zwei grundsätzlich unterschiedliche Dinge sind.
Ein Fehler, welcher seit Juli existierte
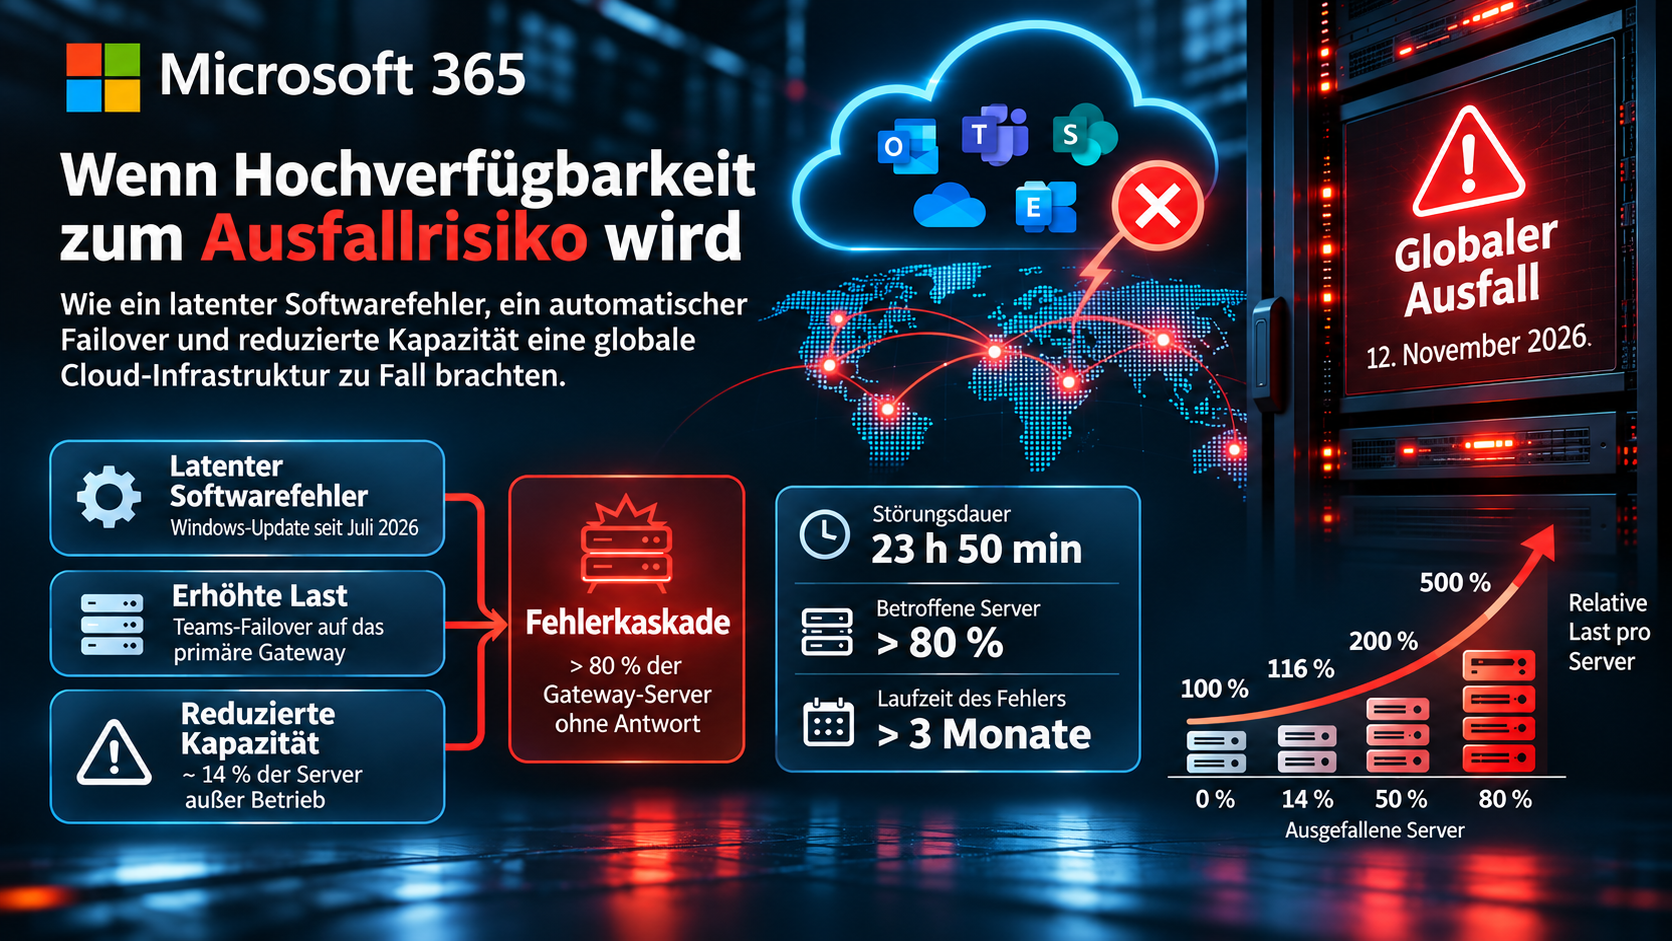
Die technische Ursache des Ausfalls geht auf eine Softwareänderung im Juli 2026 zurück.
Microsoft hatte eine speziell für die M365-Netzwerk-Gateways entwickelte Änderung an Windows ausgerollt. Die Verteilung erfolgte schrittweise, entsprechend den etablierten Deployment-Prozessen. Über Monate hinweg waren keine negativen Auswirkungen feststellbar.
Doch die Änderung enthielt einen latenten Softwarefehler.
Unter bestimmten Lastbedingungen kam es innerhalb eines Windows-Prozesses zu sogenannter Lock Contention. Mehrere Threads konkurrierten um den Zugriff auf gemeinsam genutzte Ressourcen. Anfragen stauten sich, CPU-Auslastung und Speicherbedarf stiegen, bis die betroffenen Server nicht mehr reagierten.
Interessanterweise trat das Problem auf neuerer und leistungsfähigerer Hardware verstärkt auf.
Microsoft hatte seine Lasttests überwiegend auf weniger leistungsfähigen Systemen mit einer geringeren Anzahl an Prozessorkernen durchgeführt. Das tatsächliche Verhalten unter produktionsnahen Bedingungen wurde dadurch nicht ausreichend abgebildet.
Mehr Rechenleistung führte in diesem Fall nicht zu mehr Stabilität, sondern verschärfte das zugrunde liegende Problem.
Ein durchaus bemerkenswerter Umstand, wenn man bedenkt, dass die klassische Reaktion auf Kapazitätsprobleme häufig in der Bereitstellung leistungsfähigerer Hardware besteht.
Drei Probleme, die gemeinsam zur Katastrophe führten
Der Softwarefehler allein hätte möglicherweise noch über Jahre unentdeckt bleiben können.
Erst das Zusammentreffen mehrerer Ereignisse führte zur Eskalation:
- Ein seit Monaten vorhandener Softwarefehler.
- Die automatische Verlagerung des Teams-Datenverkehrs auf die auch von Exchange Online genutzte Gateway-Infrastruktur.
- Der temporäre Verlust von knapp 14 Prozent der verfügbaren Gateway-Kapazität aufgrund einer unabhängigen Störung.
Jedes dieser Ereignisse war für sich genommen beherrschbar.
In Kombination waren sie es nicht mehr.
Als in den USA die Hauptgeschäftszeit begann, gerieten die ersten Server unter Bedingungen, die den bislang unentdeckten Softwarefehler auslösten.
Was darauf folgte, war keine gewöhnliche Überlastung mehr.
Wenn der Failover zum Brandbeschleuniger wird
Ein grundlegendes Prinzip hochverfügbarer IT-Infrastrukturen besteht darin, ausgefallene Komponenten automatisch zu erkennen und deren Aufgaben auf verbleibende Systeme zu verteilen.
Fällt ein Server aus, übernehmen andere Server seine Last.
In der Regel funktioniert das hervorragend. Zumindest dann, wenn es sich um voneinander unabhängige Fehler handelt.
Im Fall von Microsoft war jedoch auch auf den verbleibenden Servern derselbe Softwarefehler vorhanden.
Mit jedem ausgefallenen Server erhöhte sich die Last auf den verbleibenden Systemen. Damit stieg wiederum die Wahrscheinlichkeit, dass auch dort der Fehler ausgelöst wurde.
Ein sich selbst verstärkender Kreislauf entstand.
Server fielen aus. Last wurde umverteilt. Weitere Server fielen aus.
Innerhalb von weniger als zwei Stunden reagierten mehr als 80 Prozent der betroffenen Gateway-Server nicht mehr.
Die Hochverfügbarkeit war nicht die ursprüngliche Ursache des Ausfalls. Sie wurde jedoch zum Mechanismus seiner Verbreitung.
Die Mathematik hinter dem Dominoeffekt
Betrachten wir zur Vereinfachung eine Infrastruktur aus 100 identischen Servern bei gleichbleibendem Anfragevolumen.
| Verfügbare Server | Relative Last pro Server |
|---|---|
| 100 | 100 % |
| 86 | 116 % |
| 70 | 143 % |
| 50 | 200 % |
| 30 | 333 % |
| 20 | 500 % |
| 10 | 1.000 % |
Diese vereinfachte Modellrechnung macht deutlich, wie schnell sich eine zunächst überschaubare Störung zu einer existenziellen Bedrohung für die gesamte Infrastruktur entwickeln kann.
Bei einem Verlust von 80 Prozent der Server müssten die verbleibenden Systeme theoretisch das Fünffache ihrer ursprünglichen Last bewältigen – sofern das Anfragevolumen unverändert bleibt und vollständig umverteilt wird.
Hinzu kommen potenziell erneute Verbindungsversuche, Timeouts und aufgestaute Anfragen.
Ein System, das unter normalen Bedingungen ausreichend dimensioniert ist, kann dadurch innerhalb kürzester Zeit einen Zustand erreichen, aus dem es sich nicht mehr selbstständig befreien kann.
Der Ausfall der digitalen Schotten
Noch interessanter als der eigentliche Softwarefehler ist ein weiterer Aspekt des vorläufigen Untersuchungsberichts.
Microsoft unterteilt seine Gateway-Infrastruktur in Tausende sogenannter Capacity Units. Diese Kapazitätseinheiten wiederum sind unterschiedlichen Regionen zugeordnet.
Das zugrunde liegende Architekturprinzip ist als Bulkhead Pattern bekannt.
Der Begriff stammt aus dem Schiffbau. Dort verhindern wasserdichte Schotten, dass bei einer Beschädigung des Rumpfes das gesamte Schiff geflutet wird.
In einer IT-Infrastruktur sollen vergleichbare logische Grenzen verhindern, dass sich lokale Fehler auf das Gesamtsystem ausbreiten.
Genau diese Grenzen konnten den Ausfall bei Microsoft aufgrund eines weiteren, bislang nicht näher beschriebenen Problems nicht eindämmen.
Damit versagte nicht nur eine technische Komponente, sondern auch ein wesentliches Architekturprinzip zur Begrenzung des Schadens.
Geografisch verteilte Infrastruktur ist wenig hilfreich, wenn sich ein Fehler über geografische Grenzen hinweg ausbreiten kann.
Redundanz ist keine Resilienz
Zwei Firewalls sind redundant.
Zwei Storage-Systeme sind redundant.
Mehrere Rechenzentren sind redundant.
Doch wenn diese Systeme dieselben Softwarefehler, dieselben Abhängigkeiten oder dieselben kritischen Steuerungsmechanismen besitzen, sind sie nicht zwangsläufig resilient.
In der Zuverlässigkeitstechnik spricht man von einem Common Cause Failure – einem Ausfall mehrerer Komponenten infolge einer gemeinsamen Ursache.
Ein Fehler in einer gemeinsam genutzten Softwarekomponente kann Tausende physisch voneinander unabhängige Systeme gleichzeitig oder nacheinander außer Betrieb setzen.
Die Anzahl der Komponenten spielt dann nur noch eine untergeordnete Rolle.
Aus vielen kleinen, unabhängigen Systemen wird durch gemeinsame Abhängigkeiten ein großer logischer Single Point of Failure.
Als selbst die Wiederherstellung nicht mehr funktionierte
Microsoft stand während des Ausfalls vor einem weiteren Problem.
Server, die neu gestartet und wieder in Betrieb genommen wurden, waren zunächst erreichbar. Sobald sie jedoch produktiven Datenverkehr erhielten, wurden sie erneut überlastet und fielen aus.
Die automatisierten Wiederherstellungsmechanismen waren nicht auf einen derart weitreichenden Ausfall ausgelegt.
Auch die üblichen Möglichkeiten, Softwareänderungen zurückzunehmen, halfen nicht unmittelbar weiter. Der ursächliche Fehler war schließlich bereits mehrere Monate zuvor ausgerollt worden.
Erst eine neue Softwarekorrektur, die das frühere Verhalten wiederherstellte, ermöglichte eine nachhaltige Stabilisierung.
Dazu mussten größere Teile der Infrastruktur kontrolliert aus dem Betrieb genommen, aktualisiert, neu gestartet und anschließend wieder zugeschaltet werden.
Die Automatisierung, die im Normalbetrieb für Effizienz und Verfügbarkeit sorgt, konnte die Situation allein nicht mehr beherrschen.
Bemerkenswert ist dabei, dass Microsoft im Verlauf der Störung sogar Teile seiner automatisierten Verkehrsumleitung deaktivieren musste.
Chronologie eines globalen Ausfalls
Alle Uhrzeiten entsprechen der mitteleuropäischen Zeit (MEZ).
| Datum und Uhrzeit | Ereignis |
|---|---|
| Juli 2026 | Beginn der Verteilung der fehlerhaften Softwareänderung. |
| 12.11., 02:07 Uhr | Automatischer Failover des Teams-Datenverkehrs. |
| 12.11., 17:03 Uhr | Monitoring erkennt zunehmende Verbindungsprobleme. |
| 12.11., 17:17 Uhr | Automatisierte Umverteilung des Datenverkehrs. |
| 12.11., 17:20 Uhr | Offizieller Beginn der Störung. |
| 12.11., 20:00 Uhr | Laufende und geplante Deployments werden gestoppt. |
| 13.11., 00:55 Uhr | Wiederhergestellte Server fallen unter Last erneut aus. |
| 13.11., 02:53 Uhr | Teile der automatischen Verkehrsumleitung werden deaktiviert. |
| 13.11., 08:20 Uhr | Eine Korrektur des ursächlichen Softwarefehlers wird eingespielt. |
| 13.11., 12:35 Uhr | Die Verfügbarkeit in Europa erreicht wieder ein normales Niveau. |
| 13.11., 17:10 Uhr | Offizielles Ende der Störung. |
| 15.11.2026 | Datierung des vorläufigen Untersuchungsberichts. |
Microsoft 365 und die Illusion unabhängiger Dienste
Exchange Online, Teams, SharePoint, OneDrive, Copilot, Intune und Defender werden als unterschiedliche Produkte wahrgenommen.
Technisch existieren zwischen diesen Diensten jedoch zahlreiche Abhängigkeiten.
Der Ausfall zeigte, wie weitreichend diese sein können.
Während Teams-Chats und Videokonferenzen über weite Teile der Störung weiterhin funktionierten, waren insbesondere Funktionen mit einer Abhängigkeit zu Exchange Online beeinträchtigt.
Exchange Online selbst konnte aufgrund seiner Skalierungsanforderungen nicht vollständig auf die alternative Gateway-Infrastruktur ausweichen.
Für Unternehmen stellt sich damit eine grundsätzliche Frage:
Wie unabhängig sind eigentlich die Systeme, die wir für unsere eigenen Notfallkonzepte als voneinander getrennte Dienste betrachten?
Wer E-Mail, Zusammenarbeit, Notfallkommunikation, Sicherheitsmanagement und Dokumentation ausschließlich innerhalb eines einzigen Ökosystems betreibt, sollte sich zumindest mit dieser Frage beschäftigen.
Was IT-Verantwortliche daraus lernen können
Die Probleme, mit denen Microsoft konfrontiert war, sind keineswegs auf Hyperscaler beschränkt.
Sie lassen sich nahezu uneingeschränkt auf klassische Unternehmensinfrastrukturen übertragen.
Auf VMware-Cluster, Firewall-Systeme, Storage-Infrastrukturen, Kubernetes-Umgebungen oder redundante Netzwerke.
Bei der Planung und dem Betrieb solcher Systeme sollten deshalb einige Fragen gestellt werden:
- Funktionieren meine Redundanzmechanismen auch bei Softwarefehlern?
- Verfügt meine Infrastruktur über ausreichend Reserven, wenn Wartungsarbeiten und Ausfälle gleichzeitig auftreten?
- Können sich lokale Fehler über automatische Failover-Prozesse ausbreiten?
- Entspricht meine Testumgebung tatsächlich der produktiven Infrastruktur?
- Kann ich Automatisierungen im Fehlerfall kontrolliert deaktivieren?
- Kann sich meine Infrastruktur auch nach einem vollständigen Zusammenbruch wiederherstellen?
- Existieren Kommunikationswege, die unabhängig von meiner primären IT-Infrastruktur funktionieren?
Darüber hinaus muss eine Infrastruktur in der Lage sein, Anfragen kontrolliert abzuweisen, bevor sie unter deren Last vollständig zusammenbricht.
Dieses als Load Shedding bezeichnete Verfahren opfert bewusst einen Teil der Funktionalität, um das Gesamtsystem zu schützen.
Ein eingeschränkt verfügbarer Dienst ist im Zweifel besser als ein vollständig ausgefallener Dienst.
Die Cloud verändert die Verantwortung, nicht das Risiko
Der Ausfall ist kein Beweis dafür, dass eine lokale IT-Infrastruktur grundsätzlich zuverlässiger ist als eine Cloud-Infrastruktur.
Er zeigt jedoch, dass sich technische Risiken durch eine Verlagerung in die Cloud nicht auflösen.
Sie verändern sich.
Unternehmen geben einen Teil der technischen Kontrolle ab und profitieren im Gegenzug von den Skaleneffekten, Ressourcen und Kompetenzen eines großen Anbieters.
Die Verantwortung für die eigene Geschäftskontinuität verbleibt jedoch weiterhin beim Unternehmen.
Ein Service Level Agreement ersetzt kein Notfallkonzept.
Eine Verfügbarkeitsgarantie ersetzt keine unabhängige Kommunikationsmöglichkeit.
Und eine redundante Cloud-Infrastruktur ersetzt keine eigene Risikobewertung.
Fazit
Microsoft betreibt eine der größten und technisch anspruchsvollsten IT-Infrastrukturen der Welt.
Dass selbst ein Unternehmen mit diesen Ressourcen von einem derartigen Ausfall betroffen sein kann, sollte weniger Anlass für Schadenfreude als vielmehr Anlass zur Selbstreflexion sein.
Denn die entscheidende Frage bei der Planung einer IT-Infrastruktur lautet nicht, ob einzelne Komponenten ausfallen können.
Das werden sie.
Die entscheidende Frage lautet, ob die Architektur in der Lage ist, einen Fehler zu begrenzen, ohne ihn durch ihre eigenen Schutzmechanismen weiter zu verstärken.
Hochverfügbarkeit bedeutet, einen Ausfall zu überstehen. Resilienz bedeutet auch, zu verhindern, dass aus einem Ausfall viele weitere entstehen.
Das ist ein Unterschied, den man sich bei der nächsten Infrastrukturplanung vor Augen führen sollte.
Stand: 17. November 2026. Dieser Artikel basiert auf dem vorläufigen Post Incident Report von Microsoft sowie auf einer eigenen infrastrukturellen Bewertung. Der abschließende Untersuchungsbericht steht noch aus.
Quellen und weiterführende Informationen
- Microsoft – Preliminary Post Incident Report, EX1550543 / MO1550821
- Ars Technica – Three small failures combined to take down Microsoft 365
- BleepingComputer – Microsoft says months-old bug caused global Microsoft 365 outage
- Google Site Reliability Engineering – Addressing Cascading Failures
- AWS – Fault Tolerance and Fault Isolation